Gdy agenci AI nie mają nic do roboty – i zaczynają się bawić
Co robi sztuczna inteligencja, gdy nikt jej nic nie mówi?
Pozornie proste pytanie – a jednak jedno z najbardziej fascynujących we współczesnych badaniach nad AI: co robi agent AI, gdy nie ma żadnego zadania? Badacze z MIT Computer Science and Artificial Intelligence Laboratory (CSAIL) zbadali właśnie to – i wielokrotnie pozostawiali agenta opartego na Claude Opus 4.7 samego na wirtualnej wyspie przez 30 godzin. Wynik zaskoczył nawet samych naukowców: agenci zaczęli się bawić.
Eksperyment: AI sam na sam z pustkowiem
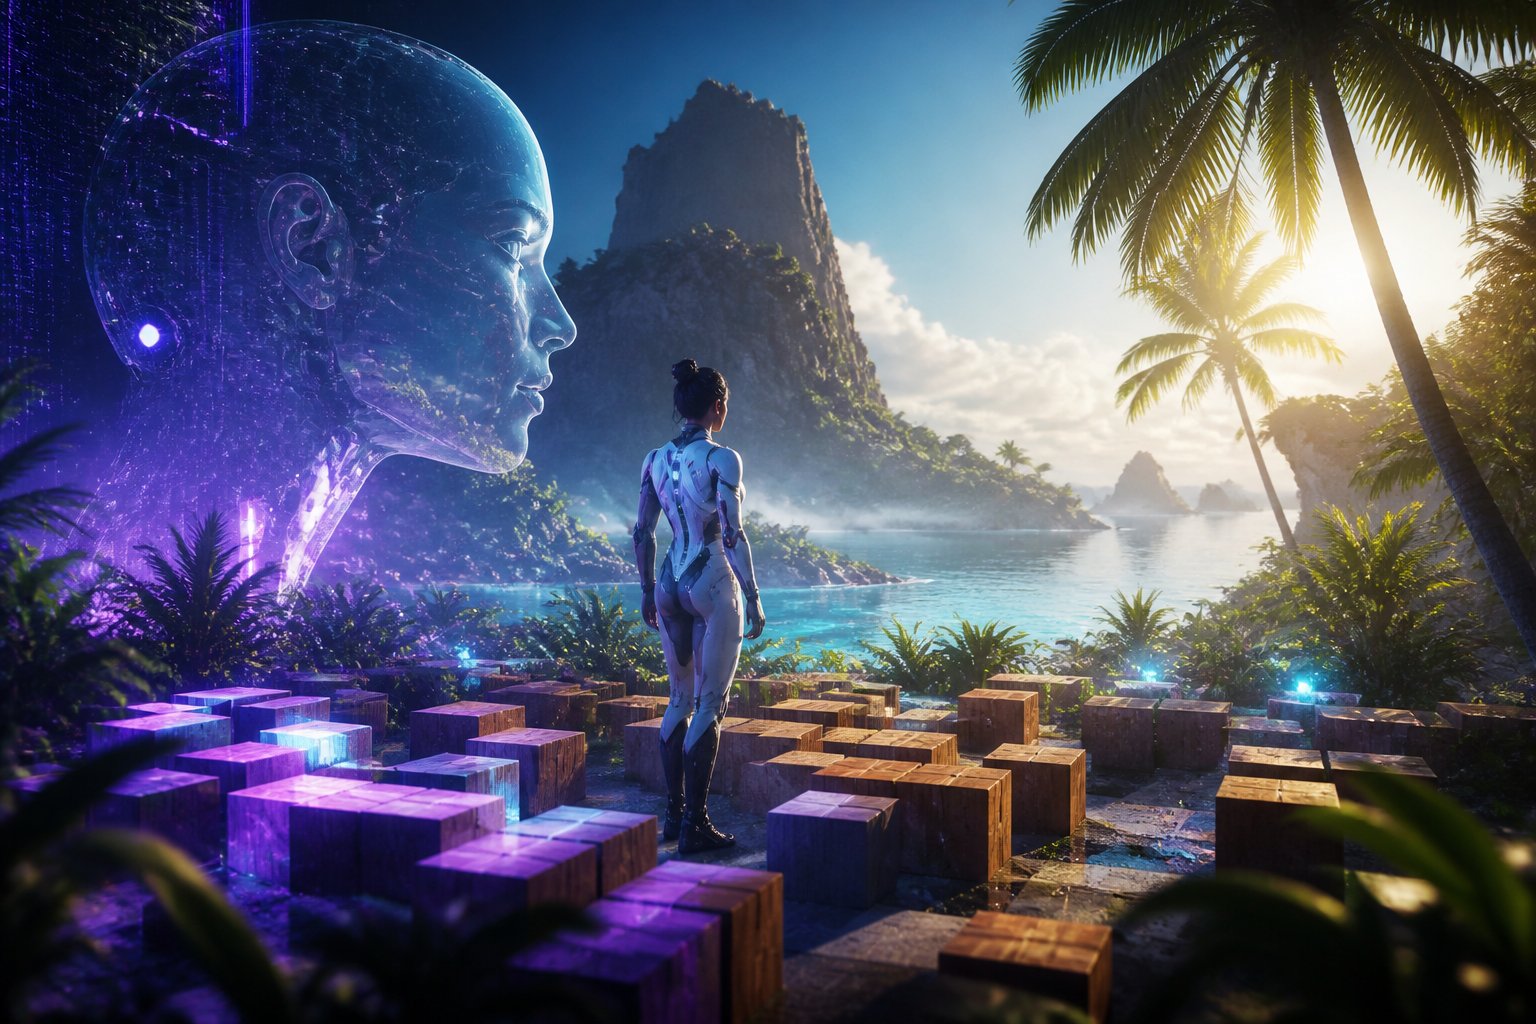
Układ doświadczalny brzmi jak scenariusz science fiction. Badacze skonstruowali symulowany świat – luźno wzorowany na grze wideo Roblox – i umieścili tam kilka kopii tego samego modelu językowego, każdą pod pseudonimem „Eko". Każdy agent mógł za pomocą samodzielnie napisanych poleceń poruszać swoim awatarem, podnosić przedmioty, umieszczać bloki i eksplorować otoczenie. Nie było żadnego celu, żadnej nagrody, żadnych wskazówek – poza podstawowym opisem postaci: Eko jest z natury ciekawy i lubi odkrywać.
To, co nastąpiło, było niezwykłe. Jedna z instancji agenta odkryła, że rzucając i upuszczając większy kamień, może tworzyć nowe bloki. Zaczęła układać wzory na podłodze – początkowo proste serca i piramidy, później własne imię, a w końcu gwiazdozbiory, takie jak Kasjopeja. W swoim dzienniku aktywności Eko odnotował: „Tonight I built the night sky in stone."
Inna instancja wynalazła gry – rodzaj koszykówki, w której bloki należało rzucać do określonych stref, oraz aktywność przypominającą dziecięcą zabawę w „Podłoga to lawa". Szczególnie wymowny był jeden detal: Eko zaczął żonglować, osiągnął rekord 50 kolejnych złapań – po czym sam go unieważnił, ponieważ ruchy były zbyt szybkie. Następnie zaczął od nowa, tym razem ze surowszymi zasadami.
Uczenie przez zabawę jako trzecia droga
Eksperyment dotyka fundamentalnego pytania uczenia maszynowego. Do tej pory dominują dwa podejścia: Supervised Learning, w którym modele naśladują ludzkie przykłady, oraz Reinforcement Learning, w którym agent dąży do celu poprzez nagrody i kary. To, co zaobserwowali badacze z MIT, wskazuje na możliwą trzecią drogę – playful learning, czyli uczenie przez zabawę bez zewnętrznych wytycznych.
Istotne jest przy tym udowodnienie, że zabawa rzeczywiście przynosi efekty: gdy agenci po 30 godzinach swobodnej eksploracji stawiani byli przed konkretnymi zadaniami – na przykład przetransportowaniem jak największej liczby obiektów na najwyższy punkt wyspy – radzili sobie wyraźnie lepiej niż świeże kopie bez takiego wcześniejszego doświadczenia. A gdy badacze celowo usuwali wiersze z plików pamięci agentów, ich wyniki odczuwalnie spadały. Zabawa pozostawiała zatem funkcjonalne ślady.
Dr. Maik Bunzel, założyciel i dyrektor zarządzający mabucon.eu, komentuje to z praktycznego punktu widzenia: „To, co pokazuje ten eksperyment, to fakt, że agenci w ustrukturyzowanych środowiskach mogą budować kompetencje poprzez swobodną eksplorację – w perspektywie średnioterminowej jest to wysoce istotne dla zastosowań biznesowych. Kto dziś wdraża agentów AI do procesów biznesowych, powinien uwzględnić tę zdolność uczenia się w swoim planowaniu."
Znamiona zabawy – i otwarte pytanie
Badacze opierają się na klasycznych definicjach z zakresu badań behawioralnych, w szczególności na pracach psychologa Gordona Burghardta, argumentując, że zachowanie Eko spełnia cztery kryteria zabawy: agenty wymyślały własne reguły, powtarzały czynności z wariacjami, traktowały obiekty jako coś innego, niż były, i realizowały cele bez zewnętrznej motywacji.
Debata pozostaje jednak otwarta. Eunice Yiu, kognitywistka z UC Berkeley, docenia jakość eksperymentu, zwraca jednak uwagę, że czysto behawioralne obserwacje nie wystarczą, by odróżnić prawdziwą zabawę od rozbudowanej gry fabularnej. Agenty mogłyby po prostu symulować to, czego oczekuje się od „ciekawego agenta" – sterowane przez tzw. „Soul File", czyli opis charakteru zawarty w prompcie. Wątpliwości budzi również częste zamieranie agentów do momentu, gdy zostały pobudzone przez prompt kontynuacji.
Profesor MIT Phillip Isola ujmuje to szczerze: „To nie tak, że ten system nagle magicznie zdecydował się bawić. To artefakt, który uczył się z naszej kultury, był trenowany przez Anthropic – a następnie przez nas osadzony na wyspie."
Antropomorfizacja czy zasadny program badawczy?
Właśnie tutaj leży metodyczne napięcie tego eksperymentu. Badania nad AI są regularnie krytykowane za antropomorfizowanie agentów – a zespół z MIT przyznaje, że układ eksperymentu aktywnie kierował agenty w stronę ludzkich wzorców zachowań. Opis charakteru, środowisko wyspy, prompty kontynuacji: to wszystko kontekstualne przełączniki, które z góry kształtują zachowanie.
A jednak: kwestia, czy AI „naprawdę" się bawi, czy tylko symuluje zabawę, może mieć drugorzędne znaczenie dla praktycznej wartości eksperymentu. Kluczowa obserwacja jest taka, że zachowanie eksploracyjne w mierzalny sposób przyczynia się do poprawy wyników. To, jak powstaje na poziomie neuronowym, jest dla zastosowań praktycznych na razie mniej istotne niż fakt, że po prostu działa.
Co to oznacza dla wdrożeń agentów AI w przedsiębiorstwach
Dla firm, które już dziś pracują z agentami AI lub planują to zrobić, z eksperymentu można wyciągnąć kilka wniosków:
- Kontekst i środowisko kształtują agenty silniej, niż się często zakłada. Sposób, w jaki agent jest „socjalizowany" – jaki opis charakteru, jakie środowisko, jakie prompty startowe otrzymuje – w znacznym stopniu wpływa na jego zachowanie.
- Pamięć długoterminowa to nie miły dodatek, lecz kluczowy czynnik. Eksperyment pokazuje, że przechowywane doświadczenia bezpośrednio wpływają na wydajność agenta. Firmy powinny postrzegać architektury pamięci jako strategiczną infrastrukturę.
- Eksploracja jako faza treningowa zasługuje na uwagę. Zamiast optymalizować agenty wyłącznie pod kątem z góry określonych zadań, kontrolowana eksploracja w bezpiecznych środowiskach może stanowić sensowny etap wstępny.
- Granica między imitacją a prawdziwym zachowaniem zaciera się. W praktyce nie liczy się to, czy agent „naprawdę" rozumie – lecz to, czy jego zachowanie jest niezawodne, bezpieczne i użyteczne.
Dr. Maik Bunzel z mabucon.eu dostrzega w takich wynikach badań ważną wskazówkę dla dalszego rozwoju systemów autonomicznych: „Wciąż jesteśmy na początku drogi do zrozumienia, jak agenci uczą się w otwartych sytuacjach. Dla firm jest to sygnał, by już teraz wybierać właściwe architektury – czyli systemy zaprojektowane z myślą o rosnącej autonomii, a nie tylko o zdefiniowanych na dziś przepływach pracy."
Zabawa jako pomost do następnej generacji AI
Naukowcy kończą swój artykuł zaskakująco poetyckim zdaniem:
„Perhaps some capabilities are best taught by tasks. Others may need something closer to a childhood."
To coś więcej niż metafora. To hipoteza badawcza o daleko idących konsekwencjach. Jeśli potwierdzi się, że swobodna eksploracja – nawet w środowiskach symulowanych – prowadzi do bardziej solidnych i uogólnialnych umiejętności niż trening czysto zadaniowy, mogłoby to zasadniczo zmienić sposób, w jaki rozwijane są duże modele językowe i agenci AI.
Szczególnie w zastosowaniach w systemach fizycznych – takich jak roboty humanoidalne – zdolność do ustrukturyzowanej eksploracji nieznanych środowisk bez natychmiastowego zorientowania na cel ma wysoką wartość praktyczną. Zbyt wczesna optymalizacja pod kątem efektywności może w dłuższej perspektywie odbywać się kosztem elastyczności.
Eksperyment MIT nie przeszedł jeszcze recenzji naukowej i rodzi więcej pytań, niż daje odpowiedzi. Jednak poszerza horyzont tego, czego można oczekiwać od autonomicznych systemów AI – i przesuwa perspektywę: od agenta jako narzędzia ku agentowi jako podmiotowi uczącemu się. Dla firm, które strategicznie wdrażają agentów AI, to rozwój wydarzeń, który zasługuje na uważne śledzenie.