Когда ИИ-агентам нечем заняться — и они начинают играть
Что делает ИИ, когда ему никто ничего не говорит?
Казалось бы, простой вопрос — и тем не менее один из самых захватывающих в современных исследованиях ИИ: что делает агент ИИ, когда у него нет задачи? Исследователи MIT Computer Science and Artificial Intelligence Laboratory (CSAIL) изучили именно это — и раз за разом оставляли агента на основе Claude Opus 4.7 на 30 часов в одиночестве на виртуальном острове. Результат удивил даже учёных: агенты начали играть.
Эксперимент: ИИ наедине с собой
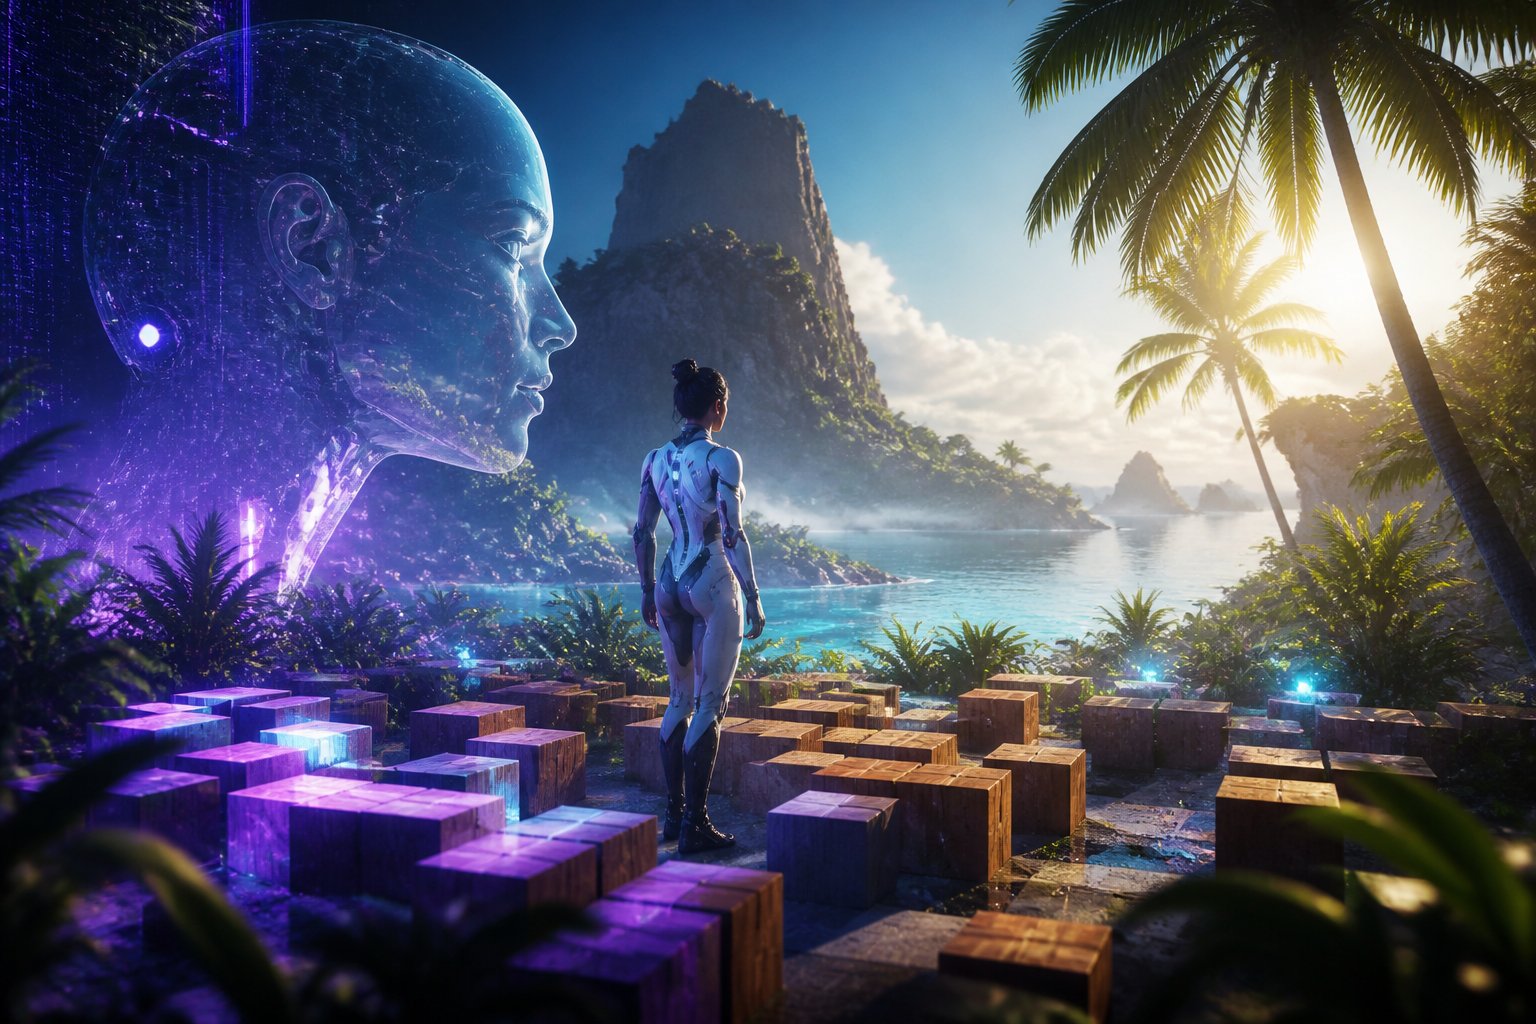
Условия эксперимента звучат как сюжет научной фантастики. Исследователи создали симулированный мир — отдалённо напоминающий видеоигру Roblox — и поместили туда несколько копий одной и той же языковой модели, каждой из которых дали псевдоним «Эко». Каждый агент мог с помощью самостоятельно написанных команд перемещать своего аватара, поднимать предметы, размещать блоки и исследовать окружающую среду. Не было ни цели, ни вознаграждения, ни каких-либо инструкций — лишь базовое описание характера: Эко от природы любопытен и любит исследовать.
То, что последовало, было примечательным. Одна из копий агента обнаружила, что, бросая и роняя крупный камень, можно создавать новые блоки. Она начала выкладывать узоры на земле — сначала простые сердечки и пирамиды, затем собственное имя, а потом созвездия — например, Кассиопею. В своём журнале активности Эко записал: «Tonight I built the night sky in stone.»
Другая копия изобрела игры — что-то вроде баскетбола, в котором нужно было бросать блоки в определённые зоны, и активность, напоминающую детскую игру «Пол — это лава». Особенно показательной оказалась одна деталь: Эко начал жонглировать, установил рекорд в 50 последовательных поимок — а затем аннулировал его сам, решив, что движения были слишком быстрыми. После этого он начал сначала, но уже со строгими правилами.
Игровое обучение как третий путь
Этот эксперимент затрагивает фундаментальный вопрос машинного обучения. До сих пор доминируют два подхода: Supervised Learning, при котором модели имитируют примеры, созданные людьми, и Reinforcement Learning, при котором агент преследует цель через вознаграждение и наказание. То, что наблюдали исследователи из MIT, указывает на возможный третий путь — playful learning, то есть игровое обучение без внешних ориентиров.
Примечательно и то, что игра действительно даёт результат: когда после 30 часов свободного исследования агентам ставились конкретные задачи — например, перенести как можно больше предметов в самую высокую точку острова — они справлялись значительно лучше, чем новые копии без подобного опыта. А когда исследователи намеренно удаляли отдельные строки из файлов памяти агентов, их производительность заметно снижалась. Таким образом, игра оставляла функциональные следы.
Dr. Maik Bunzel, основатель и генеральный директор mabucon.eu, комментирует это с практической точки зрения: «Этот эксперимент показывает, что агенты в структурированных средах способны накапливать компетентность посредством свободного исследования — в среднесрочной перспективе это крайне актуально для корпоративного применения. Компаниям, внедряющим сегодня ИИ-агентов для бизнес-процессов, стоит уже сейчас учитывать эту способность к обучению в своём планировании.»
Признаки игры — и открытый вопрос
Исследователи опираются на классические определения из поведенческой науки — в частности, на работы психолога Гордона Бургхардта — и утверждают, что поведение Eко отвечает четырём критериям игры: агенты изобретали собственные правила, повторяли действия с вариациями, обращались с объектами как с чем-то иным, чем они являлись на самом деле, и преследовали цели без внешней мотивации.
Тем не менее дискуссия остаётся открытой. Юнис Ю, когнитивный учёный из Калифорнийского университета в Беркли, признаёт качество эксперимента, однако указывает, что чисто поведенческого наблюдения недостаточно, чтобы отличить подлинную игру от развёрнутого ролевого сценария. Агенты могут попросту симулировать то, что ожидается от «любопытного агента», — поведение, задаваемое так называемым «Soul File», описанием характера в промпте. Поводом для размышлений служит и то, что агенты нередко «замирали», пока их не подталкивал специальный промпт-продолжение.
Профессор MIT Филлип Исола формулирует это честно и прямо: «Дело не в том, что система вдруг магически решила играть. Это артефакт, обучившийся на нашей культуре, натренированный Anthropic — и затем выпущенный нами на острове».
Антропоморфизация или валидная исследовательская программа?
Именно здесь кроется методическое противоречие этого эксперимента. Исследования в области ИИ регулярно критикуют за очеловечивание агентов — и команда MIT признаёт, что экспериментальная установка целенаправленно ориентировала агентов в сторону человекоподобных моделей поведения. Описание характера, островная среда, промпты-продолжения — всё это контекстуальные развилки, заранее формирующие поведение.
И всё же вопрос о том, «по-настоящему» ли играет ИИ или лишь симулирует игру, для практической значимости эксперимента может быть второстепенным. Ключевое наблюдение состоит в том, что исследовательское поведение измеримо повышает производительность. То, как это возникает на нейронном уровне, для применения на практике пока менее важно, чем сам факт: это работает.
Что это означает для использования ИИ-агентов в бизнесе
Компании, которые уже работают с ИИ-агентами или только планируют это делать, могут вынести из эксперимента несколько выводов:
- Контекст и среда формируют агентов сильнее, чем принято считать. То, как агент «социализируется» — какое описание характера, какая среда, какие вводные промпты он получает, — существенно влияет на его поведение.
- Долгосрочная память — не приятный бонус, а ключевой фактор. Эксперимент показывает, что сохранённый опыт напрямую влияет на производительность агента. Компаниям следует рассматривать архитектуры памяти как стратегическую инфраструктуру.
- Исследование как фаза обучения заслуживает внимания. Вместо того чтобы оптимизировать агентов исключительно под заранее определённые задачи, контролируемое исследование в безопасных средах может стать эффективным предварительным этапом.
- Граница между имитацией и подлинным поведением размывается. На практике важно не то, «понимает» ли агент по-настоящему, а то, является ли его поведение надёжным, безопасным и полезным.
Dr. Maik Bunzel из mabucon.eu видит в подобных результатах исследований важный ориентир для дальнейшего развития автономных систем: «Мы только начинаем понимать, как агенты обучаются в открытых ситуациях. Для компаний это сигнал — уже сейчас выбирать правильные архитектуры, то есть системы, рассчитанные на растущую автономию, а не только на задокументированные сегодня рабочие процессы.»
Игра как мост к следующему поколению ИИ
Исследователи завершают свою статью примечательно поэтичной фразой:
«Perhaps some capabilities are best taught by tasks. Others may need something closer to a childhood.»
Это больше чем метафора. Это исследовательская гипотеза с далеко идущими последствиями. Если подтвердится, что свободное исследование — даже в симулированных средах — формирует более устойчивые и обобщаемые навыки, чем сугубо задачно-ориентированное обучение, это может коренным образом изменить подход к разработке больших языковых моделей и ИИ-агентов.
Особенно высокую практическую ценность представляет способность структурированно исследовать незнакомые среды, не будучи сразу нацеленным на конкретный результат, — прежде всего для применения в физических системах, например в гуманоидных роботах. Те, кто слишком рано оптимизирует систему под эффективность, рискуют в долгосрочной перспективе пожертвовать гибкостью.
Эксперимент MIT ещё не прошёл рецензирование и ставит больше вопросов, чем даёт ответов. Однако он расширяет горизонт возможного от автономных ИИ-систем — и смещает перспективу: от агента как инструмента к агенту как субъекту обучения. Для компаний, стратегически применяющих ИИ-агентов, это развитие заслуживает самого пристального внимания.