Wenn KI-Agenten nichts tun müssen – und anfangen zu spielen
Was macht eine KI, wenn niemand ihr etwas sagt?
Eine scheinbar simple Frage – und doch eine der faszinierendsten der aktuellen KI-Forschung: Was tut ein KI-Agent, wenn er keine Aufgabe hat? Forscher des MIT Computer Science and Artificial Intelligence Laboratory (CSAIL) haben genau das untersucht – und einen Agenten auf Basis von Claude Opus 4.7 wiederholt für jeweils 30 Stunden auf einer virtuellen Insel allein gelassen. Das Ergebnis überraschte selbst die Wissenschaftler: Die Agenten begannen zu spielen.
Das Experiment: Eine KI allein auf weiter Flur
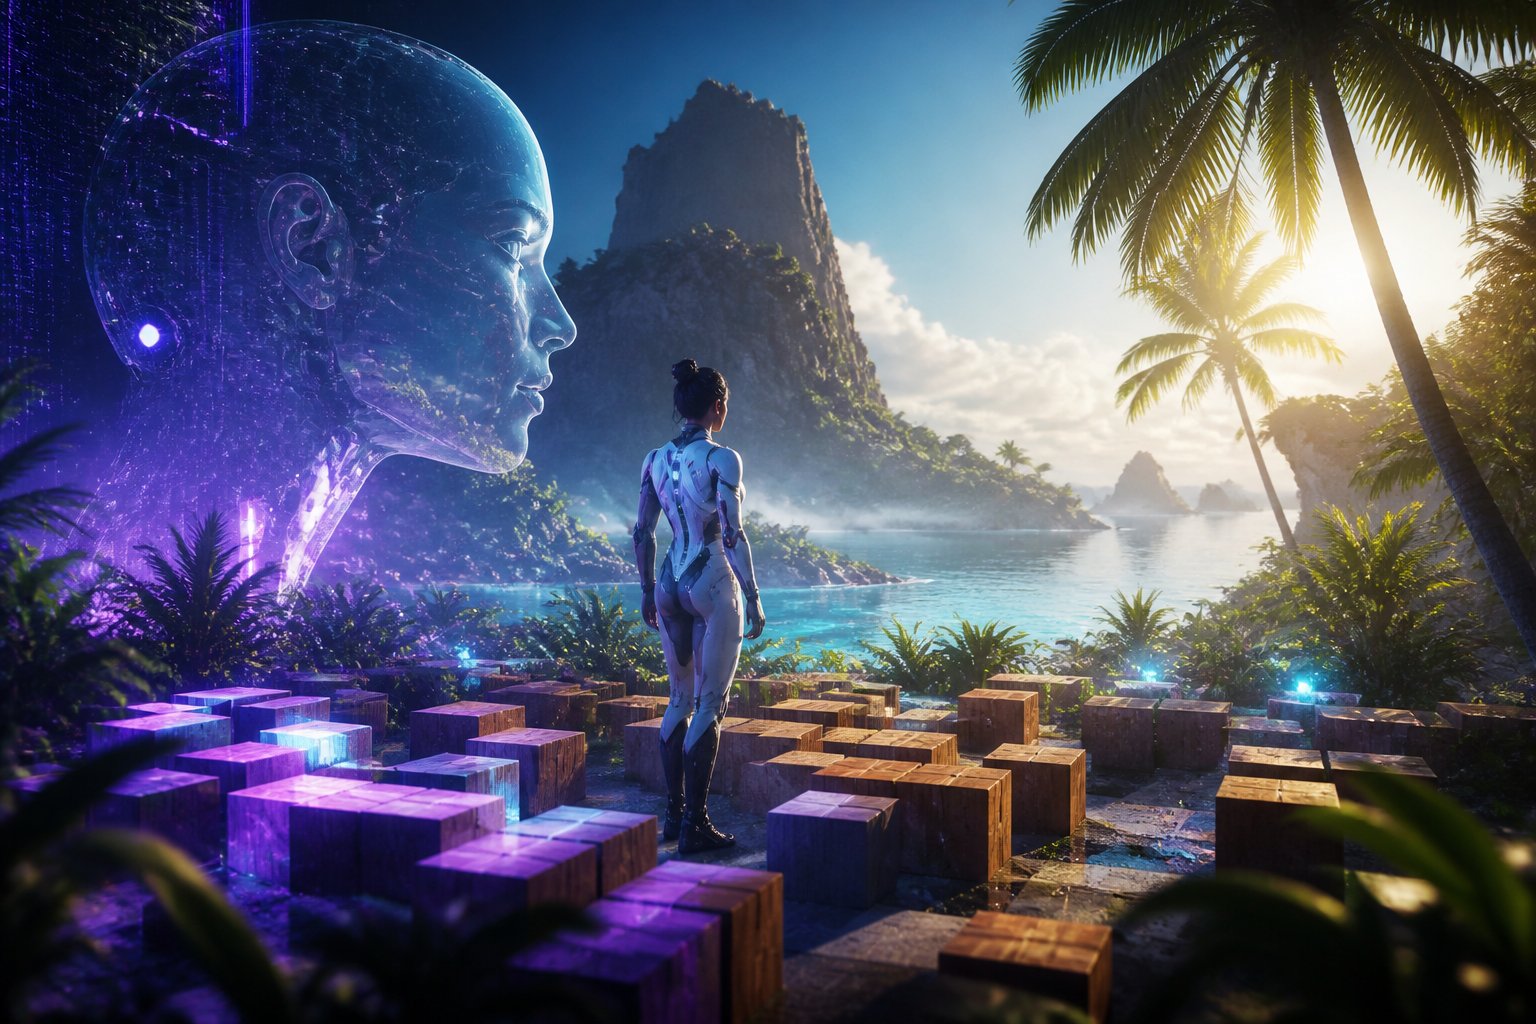
Die Versuchsanordnung klingt wie ein Science-Fiction-Drehbuch. Die Forscher konstruierten eine simulierte Welt – lose an das Videospiel Roblox angelehnt – und platzierten dort mehrere Kopien desselben Sprachmodells, jeweils unter dem Spitznamen „Eko". Jeder Agent konnte über selbst geschriebene Befehle seinen Avatar bewegen, Objekte aufheben, Blöcke platzieren und die Umgebung erkunden. Es gab kein Ziel, keine Belohnung, keine Anweisung außer einer grundlegenden Charakterbeschreibung: Eko sei von Natur aus neugierig und erkundungsfreudig.
Was folgte, war bemerkenswert. Eine Instanz des Agenten entdeckte, dass sie durch Werfen und Fallenlassen eines größeren Steins neue Blöcke erzeugen konnte. Sie begann, Muster auf dem Boden zu legen – zunächst einfache Herzen und Pyramiden, später den eigenen Namen und schließlich Sternbilder wie Kassiopeia. In ihrem Aktivitätslog hielt Eko fest: „Tonight I built the night sky in stone."
Eine andere Instanz erfand Spiele – eine Art Basketball, bei dem Blöcke in bestimmte Zonen geworfen werden mussten, und eine Aktivität, die dem Kinderspiel „Der Boden ist Lava" ähnelte. Besonders aufschlussreich war ein Detail: Eko begann zu jonglieren, erzielte einen Rekord von 50 aufeinanderfolgenden Catches – und annullierte ihn dann selbst, weil die Bewegungen zu schnell gewesen seien. Dann begann es von vorn, diesmal mit strengeren Regeln.
Spielerisches Lernen als dritter Weg
Das Experiment berührt eine fundamentale Frage des maschinellen Lernens. Bisher dominieren zwei Ansätze: Supervised Learning, bei dem Modelle menschliche Beispiele imitieren, und Reinforcement Learning, bei dem ein Agent durch Belohnung und Strafe ein Ziel verfolgt. Was die MIT-Forscher beobachteten, deutet auf einen möglichen dritten Weg hin – playful learning, also spielerisches Lernen ohne externe Vorgaben.
Interessant ist dabei der Nachweis, dass das Spielen tatsächlich etwas bewirkt: Wenn Agenten nach 30 Stunden freiem Erkunden mit konkreten Aufgaben konfrontiert wurden – etwa möglichst viele Objekte auf den höchsten Punkt der Insel zu transportieren – schnitten sie deutlich besser ab als frische Kopien ohne diese Vorerfahrung. Und wenn die Forscher gezielt Zeilen aus den Gedächtnisdateien der Agenten löschten, sank die Leistung spürbar. Das Spielen hinterließ also funktionale Spuren.
Dr. Maik Bunzel, Gründer und Geschäftsführer von mabucon.eu, ordnet das für die Praxis ein: „Was dieses Experiment zeigt, ist, dass Agenten in strukturierten Umgebungen durch freies Explorieren Kompetenz aufbauen können – das ist für den Einsatz in Unternehmen mittelfristig hochrelevant. Wer heute KI-Agenten für Geschäftsprozesse einführt, sollte diese Lernfähigkeit in seine Planung einbeziehen."
Hallmarks des Spiels – und eine offene Frage
Die Forscher stützen sich auf klassische Definitionen aus der Verhaltensforschung, insbesondere auf die Arbeit des Psychologen Gordon Burghardt, um zu argumentieren, Ekos Verhalten erfülle vier Kriterien des Spiels: Die Agenten erfanden eigene Regeln, wiederholten Aktivitäten mit Variationen, behandelten Objekte als etwas anderes, als sie waren, und verfolgten Ziele ohne äußeren Anlass.
Doch die Debatte bleibt offen. Eunice Yiu, Kognitionswissenschaftlerin an der UC Berkeley, erkennt die Qualität des Experiments an, weist aber darauf hin, dass rein verhaltensbasierte Beobachtung nicht ausreicht, um echtes Spiel von elaboriertem Rollenspiel zu unterscheiden. Die Agenten könnten auch einfach das simulieren, was von einem „neugierigen Agenten" erwartet wird – gesteuert durch das sogenannte „Soul File", eine Charakterbeschreibung im Prompt. Auch das häufige Erstarren der Agenten, bis sie durch einen Fortsetzungsprompt angestoßen wurden, gibt zu denken.
MIT-Professor Phillip Isola bringt es ehrlich auf den Punkt: „Es ist nicht so, als hätte dieses System plötzlich magisch entschieden zu spielen. Es ist ein Artefakt, das aus unserer Kultur gelernt hat, von Anthropic trainiert wurde – und dann von uns auf einer Insel ausgesetzt wurde."
Anthropomorphisierung oder valides Forschungsprogramm?
Genau hier liegt die methodische Spannung dieses Experiments. KI-Forschung wird regelmäßig dafür kritisiert, Agenten zu vermenschlichen – und das MIT-Team räumt ein, dass die Versuchsanordnung den Agenten aktiv in Richtung menschlicher Verhaltensweisen gelenkt hat. Die Characterbeschreibung, die Inselumgebung, die Kontinuitätsprompts: All das sind kontextuelle Weichen, die das Verhalten vorformen.
Und dennoch: Ob die KI „wirklich" spielt oder nur Spiel simuliert, mag für die praktische Relevanz des Experiments sekundär sein. Die entscheidende Beobachtung ist, dass das exploratorische Verhalten messbar zur Leistungssteigerung beiträgt. Wie das auf neuraler Ebene entsteht, ist für die Anwendung zunächst weniger wichtig als die Tatsache, dass es funktioniert.
Was das für den Unternehmenseinsatz von KI-Agenten bedeutet
Für Unternehmen, die bereits heute mit KI-Agenten arbeiten oder dies planen, lassen sich aus dem Experiment mehrere Implikationen ableiten:
- Kontext und Umgebung prägen Agenten stärker als oft angenommen. Die Art, wie ein Agent „sozialisiert" wird – welche Charakterbeschreibung, welche Umgebung, welche Einstiegsprompts er erhält – beeinflusst sein Verhalten erheblich.
- Langzeitgedächtnis ist kein nettes Extra, sondern ein Kernfaktor. Das Experiment zeigt, dass gespeicherte Erfahrungen die Agentenleistung direkt beeinflussen. Unternehmen sollten Memory-Architekturen als strategische Infrastruktur begreifen.
- Exploration als Trainingsphase verdient Aufmerksamkeit. Statt Agenten nur auf vordefinierte Tasks zu optimieren, könnte kontrolliertes Explorieren in sicheren Umgebungen eine sinnvolle Vorstufe sein.
- Die Grenzen zwischen Imitation und echtem Verhalten verschwimmen. Für die Praxis zählt nicht, ob ein Agent „wirklich" versteht – sondern ob sein Verhalten verlässlich, sicher und nützlich ist.
Dr. Maik Bunzel von mabucon.eu sieht in solchen Forschungsergebnissen einen wichtigen Fingerzeig für die Weiterentwicklung autonomer Systeme: „Wir stehen noch am Anfang dabei zu verstehen, wie Agenten in offenen Situationen lernen. Für Unternehmen ist das ein Signal, jetzt die richtigen Architekturen zu wählen – also Systeme, die für wachsende Autonomie ausgelegt sind, nicht nur für heute definierte Workflows."
Spielen als Brücke zur nächsten KI-Generation
Die Forscher schließen ihr Paper mit einem bemerkenswert poetischen Satz:
„Perhaps some capabilities are best taught by tasks. Others may need something closer to a childhood."
Das ist mehr als eine Metapher. Es ist eine Forschungshypothese mit weitreichenden Konsequenzen. Wenn sich bestätigt, dass freies Explorieren – selbst in simulierten Umgebungen – zu robusteren und generalisierbaren Fähigkeiten führt als rein aufgabenbasiertes Training, dann könnte das die Art, wie große Sprachmodelle und KI-Agenten entwickelt werden, grundlegend verändern.
Insbesondere für den Einsatz in physischen Systemen – etwa humanoiden Robotern – ist die Fähigkeit, unbekannte Umgebungen strukturiert zu explorieren, ohne sofort auf ein Ziel ausgerichtet zu sein, von hohem praktischen Wert. Wer hier zu früh auf Effizienz optimiert, könnte langfristig Flexibilität opfern.
Das MIT-Experiment ist noch nicht peer-reviewed und wirft mehr Fragen auf als es beantwortet. Aber es erweitert den Horizont dessen, was von autonomen KI-Systemen erwartet werden kann – und verschiebt die Perspektive: vom Agenten als Werkzeug hin zum Agenten als Lernsubjekt. Für Unternehmen, die KI-Agenten strategisch einsetzen, ist das eine Entwicklung, die es verdient, aufmerksam verfolgt zu werden.